
把大模型接到手机上,最常见的做法是“截图 → 问模型点哪 → 点一下”。演示很惊艳,上规模就崩:不知道做到第几步、失败了不知道、多台设备互相抢任务。
真正能用的方案要同时满足三件事:理解意图、真正操作手机、证明做对了。
四层结构
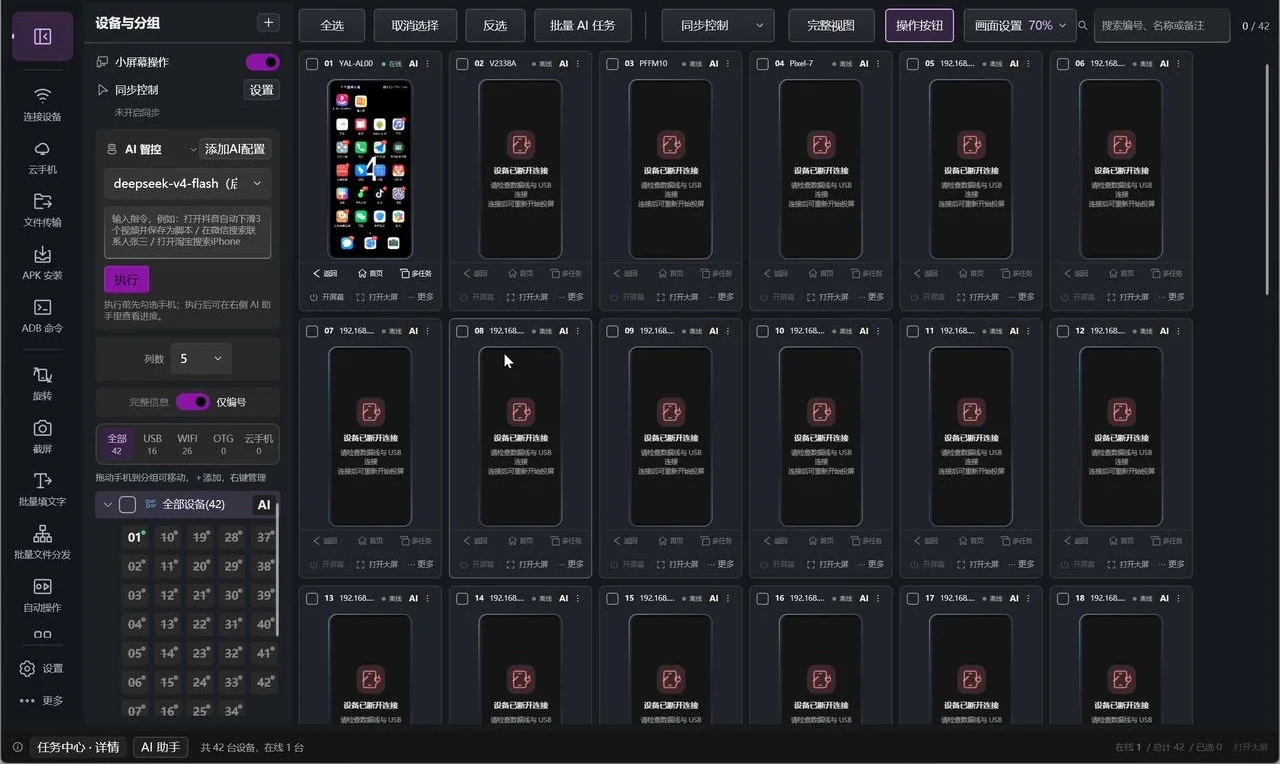
诺程投屏的 AI 架构分成四层:
- 入口层:自然语言、语音或多选设备指令;
- 规划层(总控):低频决策,把需求拆成设备级任务,决定先后与优先级,不直接操作手机;
- 调度层:持久队列,负责优先级、并发与模型配额;
- 执行层(设备智能体):每台设备独立观察画面、决定动作、执行并留存证据。
再加一个执行器:未知界面交给模型,固定界面走快速技能与本地视觉检测。这样既不会所有事都问模型,也不会在固定界面上浪费模型配额。
为什么要“验证”
动作执行完不等于目标达成。点错按钮、页面没加载、弹窗挡住,都会让“看起来做了”变成“其实没做”。
所以每台设备执行后要做结果断言:
- 已验证:目标达成且最终页面通过核对;
- 未验证:动作完成,但最终页面没通过核对;
- 失败:结果不符合预期,可查看日志与截图;
- 不确定:断连、锁屏等环境异常,无法判断。
只有“已验证”的行为可以保存为可复用脚本或任务模板。这条规则避免了把错误流程固化成“标准”。
调度与可靠性
- 任务与状态写入本地数据库,关闭窗口或重启程序不丢失;
- 每台设备同一时刻只有一个执行主体,避免任务互相争抢;
- 长任务在节点边界保存检查点,中断后可续接;
- 全局模型调用配额默认 5 路,防止多设备同时请求被限流。
配额这一条经常被忽略:30 台设备同时向模型发请求,接口会限流,结果是集体超时。限流不如排队。
模型可以换,流程不能乱
预置支持 DeepSeek、通义千问·阿里云百炼、智谱 GLM、月之暗面 Kimi、硅基流动、火山方舟(豆包)、OpenAI、本机服务(Ollama / LM Studio)与手动填写,最多保存 32 套配置。
换模型只影响“理解与决策质量”,不应该影响任务状态机与验证逻辑——这是架构分层带来的好处。
什么时候别用 AI
- 界面固定、步骤明确 → 录制回放更快更稳;
- 需要毫秒级响应 → AI 不适合;
- 涉及支付、删除等不可逆操作 → 人工确认。
AI 适合的是“界面不固定、但目标明确”的任务,比如在不同版本 App 里找到同一个入口。
上手建议
- 先用一台设备跑一个简单任务,观察每一步的截图与判断;
- 确认“验证”规则是否可靠,再扩到一组;
- 把已验证的流程保存成模板,减少重复调用模型;
- 保留人工确认环节,尤其是首次执行。
能力边界见功能全景的 AI 智能体章节:成功率受界面复杂度影响,最终页面需要人工确认。
常见问题
AI 操作手机需要配置模型 API 吗?
需要。软件预置多家模型供应商,也支持本机服务(Ollama / LM Studio)与手动填写,最多保存 32 套配置。
AI 任务失败了会怎样?
会标记为失败或不确定,并保留日志与截图;不会把未验证的结果标成已完成。
AI 能完全替代录制回放吗?
不能。固定界面用录制回放更快、更省配额;AI 更适合界面不可预知的任务。
